操作系统:调度算法
进程调度算法
先来先服务调度算法
最简单的一个调度算法,就是非抢占式的先来先服务(First Come First Severd,FCFS)算法了。顾名思义,先来后到,每次从就绪队列选择最先进入队列的进程,然后一直运行,直到进程退出或被阻塞,才会继续从队列中选择第一个进程接着运行。
这似乎很公平,但是当一个长作业先运行了,那么后面的短作业等待的时间就会很长,不利于短作业。
FCFS对长作业有利,适用于CPU繁忙型作业的系统,而不适用于I/O繁忙型作业的系统。
最短作业优先调度算法
最短作业优先(Shortest Job First SJF)调度算法同样也是顾名思义,它会优先选择运行时间最短的进程来运行,这有助于提高系统的吞吐量。
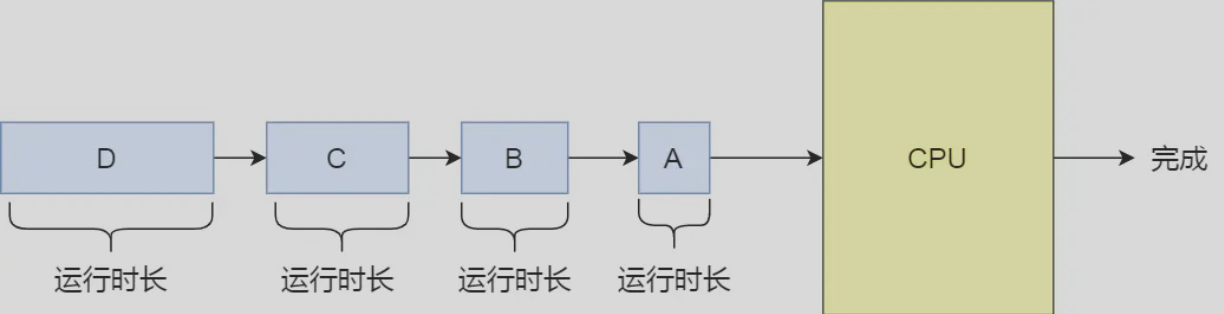
这显然对长作业不利,很容易造成一种极端现象。比如,一个长作业在就绪队列等待运行,而这个就绪队列有非常多的短作业,那么就会使得长作业不断的往后推,周转时间变长,致使长作业长期不会被运行。
高响应比优先调度算法
前面的「先来先服务调度算法」和「最短作业优先调度算法」都没有很好的权衡短作业和长作业。那么,高响应比优先(Highest Response Ratio Next, HRRN) 调度算法主要是权衡了短作业和长作业。每次进行进程调度时,先计算「响应比优先级」,然后把「响应比优先级」最高的进程投入运行,「响应比优先级」的计算公式:
从上面的公式,可以发现:如果两个进程的「等待时间」相同时,「要求的服务时间」越短,「响应比」就越高,这样短作业的进程容易被选中运行;如果两个进程「要求的服务时间」相同时,「等待时间」越长,「响应比」就越高,这就兼顾到了长作业进程,因为进程的响应比可以随时间等待的增加而提高,当其等待时间足够长时,其响应比便可以升到很高,从而获得运行的机会;
时间片轮转调度算法
最古老、最简单、最公平且使用最广的算法就是时间片轮转(Round Robin,RR)调度算法。
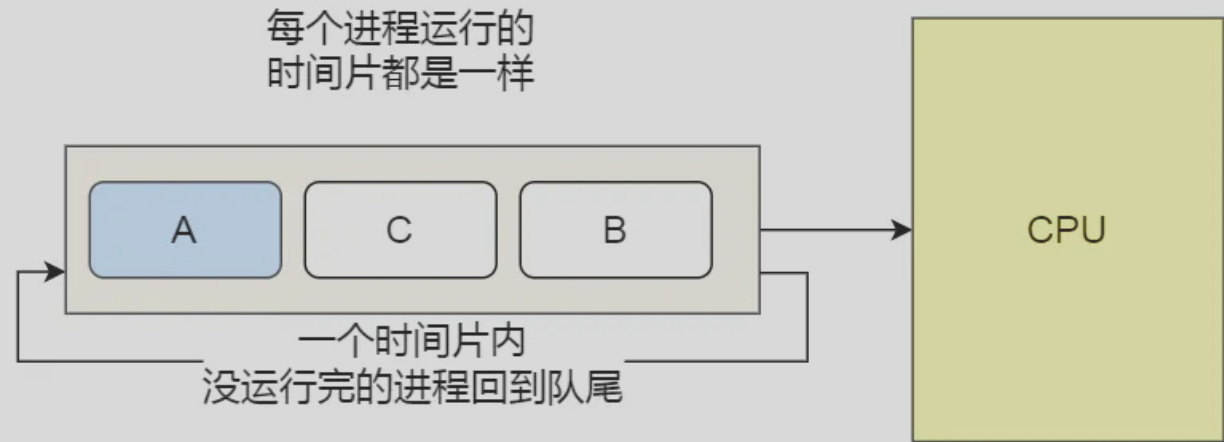
每个进程被分配一个时间段,称为时间片(Quantum),即允许该进程在该时间段中运行。
如果时间片用完,进程还在运行,那么将会把此进程从CPU释放出来,并把CPU分配另外一个进程;
如果该进程在时间片结束前阻塞或结束,则CPU立即进行切换;
另外,时间片的长度就是一个很关键的点:
如果时间片设得太短会导致过多的进程上下文切换,降低了CPU效率;
如果设得太长又可能引起对短作业进程的响应时间变长;
通常时间片设为20ms~5oms 通常是一个比较合理的折中值。
最高优先级调度算法
前面的「时间片轮转算法」做了个假设,即让所有的进程同等重要,也不偏袒谁,大家的运行时间都一样。
但是,对于多用户计算机系统就有不同的看法了,它们希望调度是有优先级的,即希望调度程序能从就绪队列中选择最高优先级的进程进行运行,这称为最高优先级(Highest Priority First,HPF)调度算法。
进程的优先级可以分为,静态优先级或动态优先级:
静态优先级:创建进程时候,就已经确定了优先级了,然后整个运行时间优先级都不会变化;
动态优先级:根据进程的动态变化调整优先级,比如如果进程运行时间增加,则降低其优先级,如果进程等待时间(就绪队列的等待时间)增加,则升高其优先级,也就是随着时间的推移增加等待进程的优先级;
该算法也有两种处理优先级高的方法,非抢占式和抢占式:
非抢占式:当就绪队列中出现优先级高的进程,运行完当前进程,再选择优先级高的进程。
抢占式:当就绪队列中出现优先级高的进程,当前进程挂起,调度优先级高的进程运行。
但是依然有缺点,可能会导致低优先级的进程永远不会运行。
多级反馈队列调度算法
多级反馈队列(Multilevel Feedback Queue)调度算法是「时间片轮转算法」和「最高优先级算法」的综合和发展。顾名思义:「多级」表示有多个队列,每个队列优先级从高到低,同时优先级越高时间片越短。「反馈」表示如果有新的进程加入优先级高的队列时,立刻停止当前正在运行的进程,转而去运行优先级更高的队列
它是如何工作的:
设置了多个队列,赋予每个队列不同的优先级,每个队列优先级从高到低,同时优先级越高时间片越短;
新的进程会被放入到第一级队列的末尾,按先来先服务的原则排队等待被调度,如果在第一级队列规定的时间片没运行完成,则将其转入到第二级队列的末尾,以此类推,直至完成;
当较高优先级的队列为空,才调度较低优先级的队列中的进程运行。如果进程运行时,有新进程进入较高优先级的队列,则停止当前运行的进程并将其移入到原队列未尾,接着让较高优先级的进程运行;
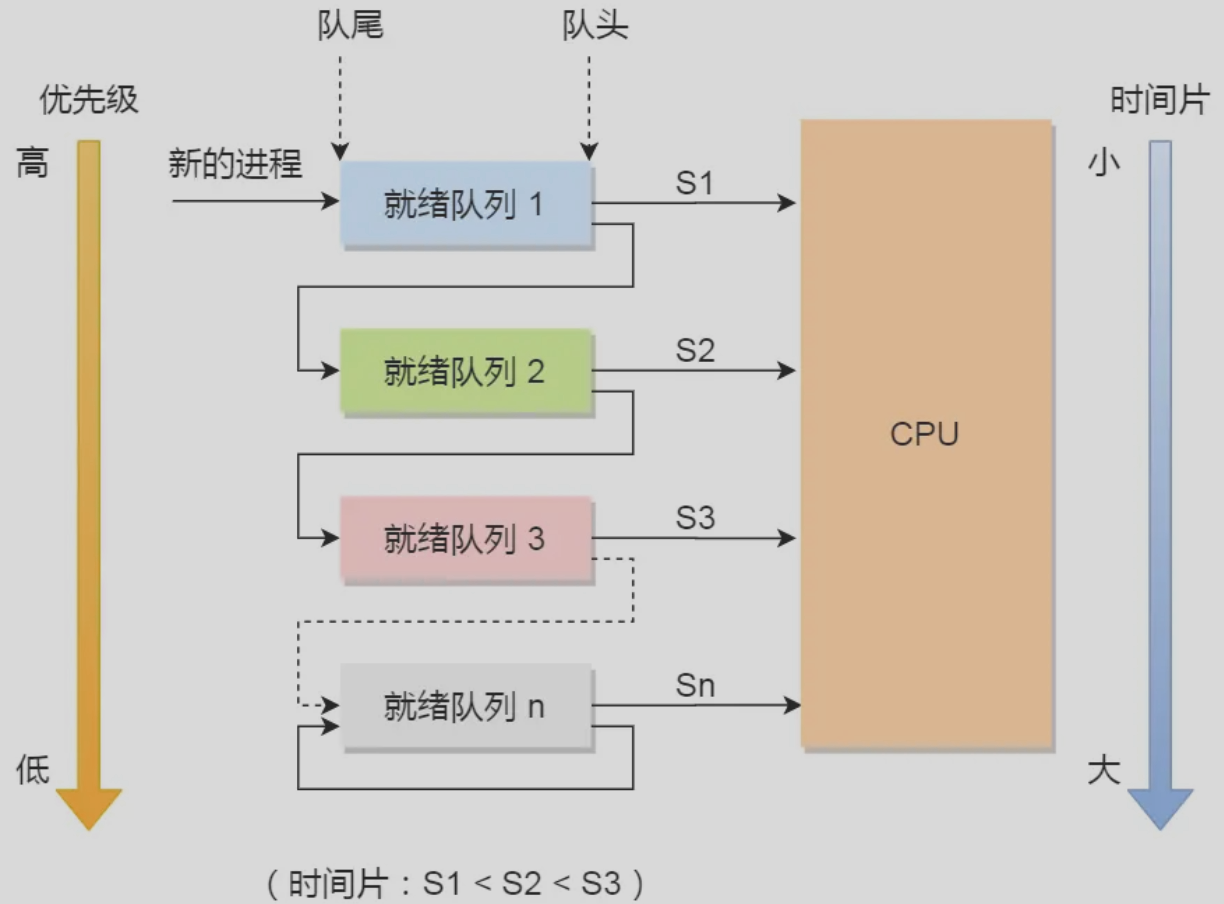
可以发现,对于短作业可能可以在第一级队列很快被处理完。对于长作业,如果在第一级队列处理不完,可以移入下次队列等待被执行,虽然等待的时间变长了,但是运行时间也会更长了,所以该算法很好的兼顾了长短作业,同时有较好的响应时间。
补充调度策略:彩票调度
基本概念
接下来,我们把CPU想得简单一点,只有一个核心,一次只能运行一个task,对于每一个task,我们给它一些彩票,每一个task得到的彩票数量就是它应该占有CPU时间的份额。假设有两个进程 A 和 B,A 拥有 75 张彩票,B 拥有 25 张。因此 我们希望 A 占用 75%的 CPU 时间,而 B 占用 25%
通过不断定时地(比如,每个时间片)抽取彩票,彩票调度从概率上(但不是确定的) 获得这种份额比例。抽取彩票的过程很简单:调度程序知道总共的彩票数(在我们的例子 中,有 100 张)。调度程序抽取中奖彩票,这是从 0 和 99 之间的一个数,拥有这个数对应 的彩票的进程中奖。假设进程 A 拥有 0 到 74 共 75 张彩票,进程 B 拥有 75 到 99 的 25 张, 中奖的彩票就决定了运行 A 或 B。调度程序然后加载中奖进程的状态,并运行它。
1 | int main() { |

从这个例子中可以看出,彩票调度中利用了随机性,这导致了从概率上满足期望的比例, 但并不能确保。在上面的例子中,工作 B 运行了 20 个时间片中的 6 个,只是占了 30%,而不是 期望的 25%。但是,这两个工作运行得时间越长,它们得到的 CPU 时间比例就会越接近期望。
提示:用彩票来表示份额 彩票(步长)调度的设计中,最强大(且最基本)的机制是彩票。在这些例子中,彩票用于表示一 个进程占有 CPU 的份额,但也可以用在更多的地方。比如在虚拟机管理程序的虚存管理的最新研究工 作中,Waldspurger 提出了用彩票来表示用户占用操作系统内存份额的方法[W02]。因此,如果你需要通 过什么机制来表示所有权比例,这个概念可能就是彩票。
具体实现
彩票调度中最不可思议的,或许就是实现简单。只需要一个不错的随机数生成器来选 择中奖彩票和一个记录系统中所有进程的数据结构(一个列表),以及所有彩票的总数。 假定我们用列表记录进程。下面的例子中有 A、B、C 这 3 个进程,每个进程有一定数量的彩票。
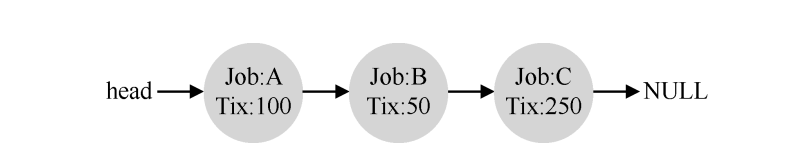
在做出调度决策之前,首先要从彩票总数 400 中选择一个随机数(中奖号码)。假设 选择了 300。然后,遍历链表,用一个简单的计数器帮助我们找到中奖者
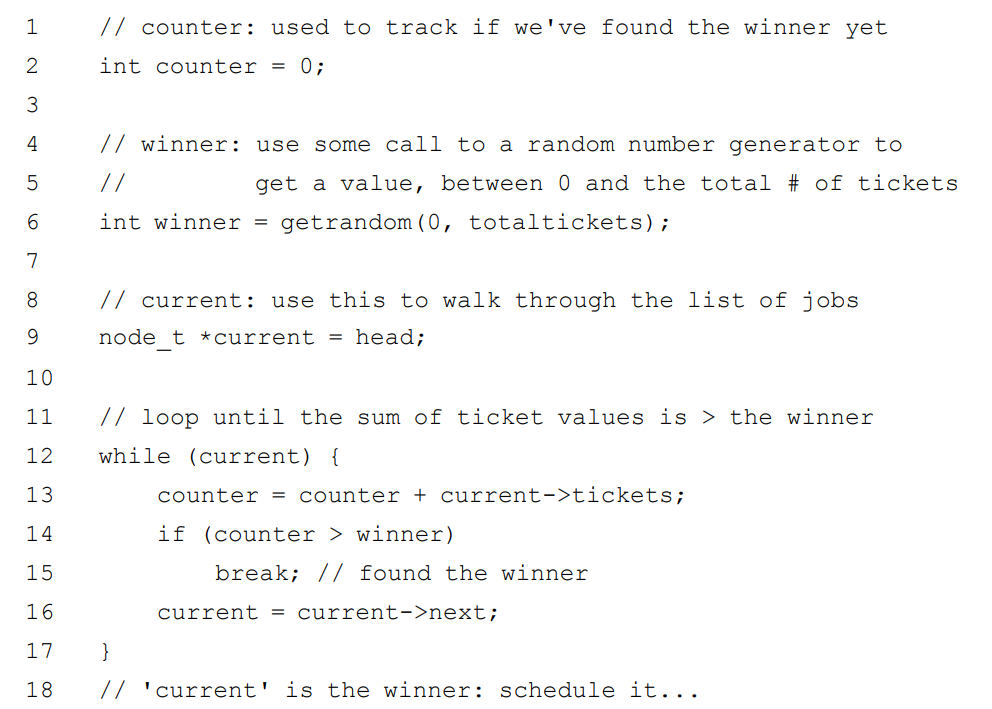
这段代码从前向后遍历进程列表,将每张票的值加到 counter 上,直到值超过 winner。 这时,当前的列表元素所对应的进程就是中奖者。在我们的例子中,中奖彩票是 300。首先, 计 A 的票后,counter 增加到 100。因为 100 小于 300,继续遍历。然后 counter 会增加到 150 (B 的彩票),仍然小于 300,继续遍历。最后,counter 增加到 400(显然大于 300),因此退 出遍历,current 指向 C(中奖者)。 要让这个过程更有效率,建议将列表项按照彩票数递减排序。这个顺序并不会影响算 法的正确性,但能保证用最小的迭代次数找到需要的节点,尤其当大多数彩票被少数进程 掌握时。
例子
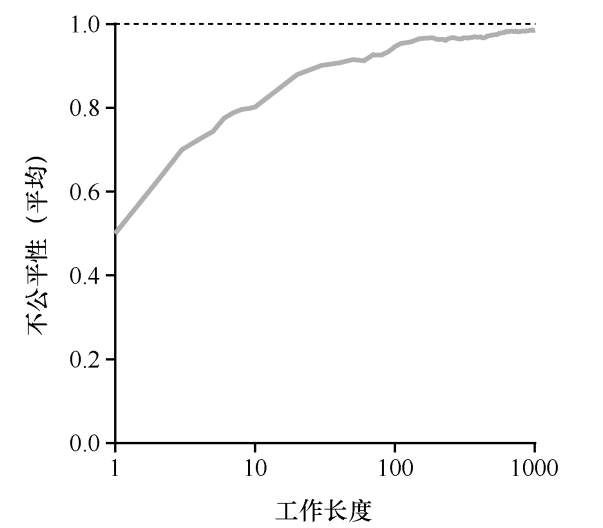
为了更好地理解彩票调度的运行过程,我们现在简单研究一下两个互相竞争工作的完 成时间,每个工作都有相同数目的 100 张彩票,以及相同的运行时间 R(稍后会改变)。 这种情况下,我们希望两个工作在大约同时完 成,但由于彩票调度算法的随机性,有时一个工作 会先于另一个完成。为了量化这种区别,我们定义 了一个简单的不公平指标 U(unfairness metric),将 两个工作完成时刻相除得到 U 的值。比如,运行时 间 R 为 10,第一个工作在时刻 10 完成,另一个在 20,U=10/20=0.5。如果两个工作几乎同时完成,U 的值将很接近于 1。在这种情况下,我们的目标是: 完美的公平调度程序可以做到 U=1。 图 9.2 展示了当两个工作的运行时间从 1 到 1000 变化时,30 次试验的平均 U 值(利用本章末 尾的模拟器产生的结果)。可以看出,当工作执行时 间很短时,平均不公平度非常糟糕。只有当工作执行非常多的时间片时,彩票调度算法才 能得到期望的结果。
步长调度
从上面的内容可以看出,虽然随机方式 可以使得调度程序的实现简单(且大致正确),但偶尔并不能产生正确的比例,尤其在工作 运行时间很短的情况下。由于这个原因,Waldspurger 提出了步长调度(stride scheduling), 一个确定性的公平分配算法
步长调度也很简单。系统中的每个工作都有自己的步长,这个值与票数值成反比。在 上面的例子中,A、B、C 这 3 个工作的票数分别是 100、50 和 250,我们通过用一个大数 分别除以他们的票数来获得每个进程的步长。比如用 10000 除以这些票数值,得到了 3 个 进程的步长分别为 100、200 和 40。我们称这个值为每个进程的步长(stride)。每次进程运 行后,我们会让它的计数器 [称为行程(pass)值] 增加它的步长,记录它的总体进展。
之后,调度程序使用进程的步长及行程值来确定调度哪个进程。基本思路很简单:当 需要进行调度时,选择目前拥有最小行程值的进程,并且在运行之后将该进程的行程值增 加一个步长。下面是 Waldspurger[W95]给出的伪代码:
1 | current = remove_min(queue); // pick client with minimum pass |
在我们的例子中,3 个进程(A、B、C)的步长值分别为 100、200 和 40,初始行程值 都为 0。因此,最初,所有进程都可能被选择执行。假设选择 A(任意的,所有具有同样低 的行程值的进程,都可能被选中)。A 执行一个时间片后,更新它的行程值为 100。然后运 行 B,并更新其行程值为 200。最后执行 C,C 的行程值变为 40。这时,算法选择最小的行 程值,是 C,执行并增加为 80(C 的步长是 40)。然后 C 再次运行(依然行程值最小),行 程值增加到 120。现在运行 A,更新它的行程值为 200(现在与 B 相同)。然后 C 再次连续 运行两次,行程值也变为 200。此时,所有行程值再次相等,这个过程会无限地重复下去。 下表展示了一段时间内调度程序的行为。
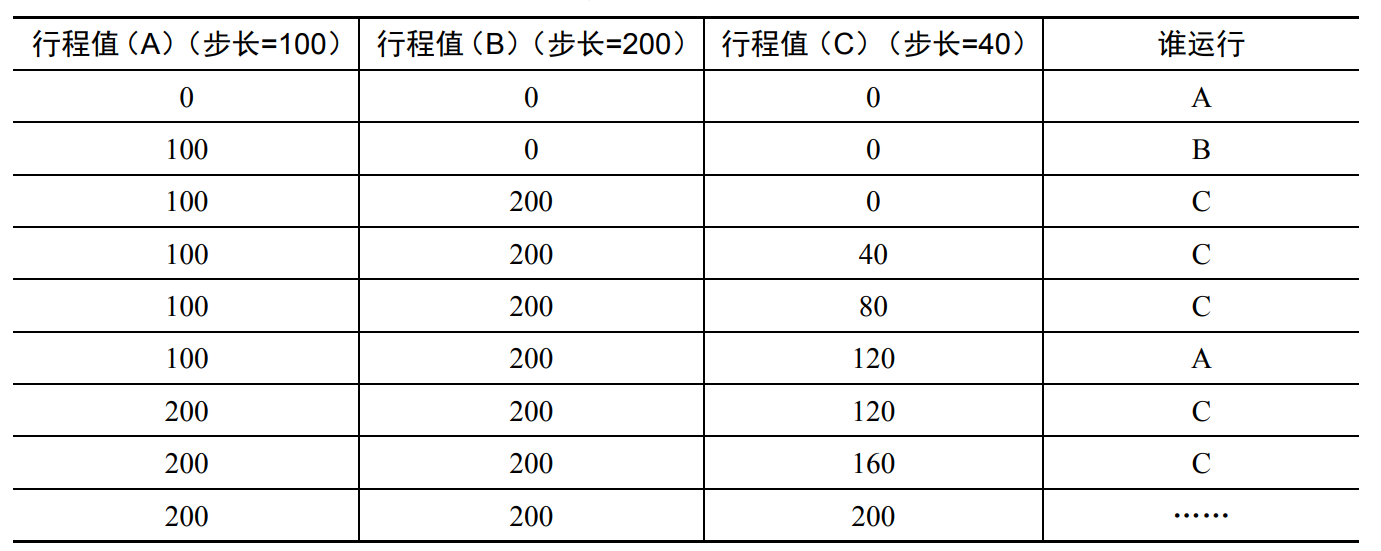
可以看出,C 运行了 5 次、A 运行了 2 次,B 一次,正好是票数的比例——200、100 和 50。 彩票调度算法只能一段时间后,在概率上实现比例,而步长调度算法可以在每个调度周期 后做到完全正确
你可能想知道,既然有了可以精确控制的步长调度算法,为什么还要彩票调度算法 呢?好吧,彩票调度有一个步长调度没有的优势——不需要全局状态。假如一个新的进程在上面的步长调度执行过程中加入系统,应该怎么设置它的行程值呢?设置成 0 吗? 这样的话,它就独占 CPU 了。而彩票调度算法不需要对每个进程记录全局状态,只需要 用新进程的票数更新全局的总票数就可以了。因此彩票调度算法能够更合理地处理新加 入的进程。
end
彩票调度通过随机值,聪明地做到了按比例分配。步长调度算法能够确定的获得需要的比例。虽然两者都很有趣,但由于一些原因,并没有作为 CPU 调度程序被广泛使用。一 个原因是这两种方式都不能很好地适合 I/O;另一个原因是其中最难的票数分配问题并没有确定的解决方式,例如,如何知道浏览器进程应该拥有多少票数?通用调度程序(像 MLFQ 及其他类似的 Linux 调度程序)做得更好,因此得到了广泛的应用。